
双语静态站的站内搜索:Pagefind 的取舍
静态站没有后端,搜索只能在构建时把索引烘进产物。Pagefind 适合这里,但它对中文不分词、构建日志还会刷一行「不支持词干」——都不是 bug。
静态站做搜索只有两条路:要么把查询发给第三方,要么在构建时把索引烘进产物。我选后者,因为不想为一个搜索框引入外部依赖,也不想让访客的查询词经过别人的服务器。
为什么是 Pagefind
试过几个方案,最后留下 Pagefind,原因是三点:
- 索引在构建后生成,产物是纯静态文件,托管侧零配置
- 按页切片,只有真正搜索时才加载对应分片,不会一次拉全量索引
- 支持多语言,一个站可以建多套索引
代价是它只能搜到构建时存在的内容。动态数据(比如歌单)搜不到——这在我看来是合理的边界:搜索是给文章用的。
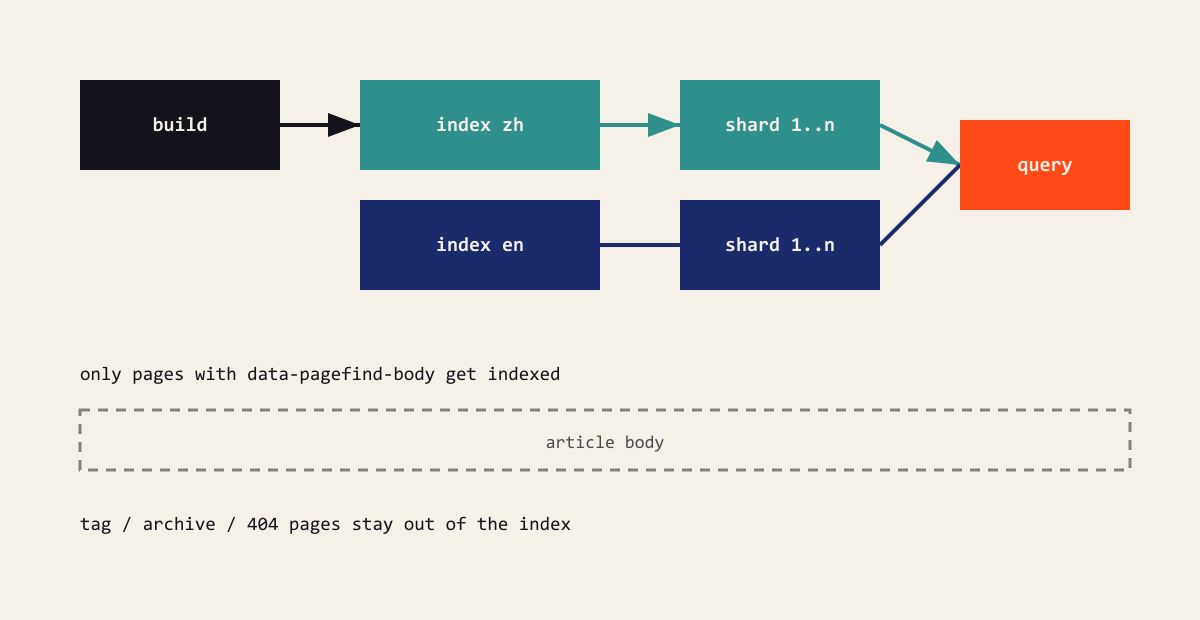
图:索引在构建时生成,按语言分开,按页切片。
中文不分词不是 bug
每次构建都会打印:
Note: Pagefind doesn't support stemming for the language zh-cn.第一次看到以为是配置错了,查下来发现是设计如此:Pagefind 的词干器基于 Snowball,只覆盖拉丁语系。中文没有词形变化,本来就不该做词干——按字检索反而是对的。
这行提示关不掉(硬编码在二进制里,--quiet 挡不住),我的处理是在构建脚本里按整行精确匹配滤掉,其余 stderr 原样转发、退出码保留。别为了图安静换成 --silent,那会连真正的报错一起吞掉。
索引范围要显式声明
Pagefind 默认扫描所有 HTML,但站点里有大量不该被搜到的页面:标签页、归档页、分页、404。全塞进去只会让结果变脏。
做法是只给正文页加标记:
<article data-pagefind-body>只有带这个属性的页面才会被索引。构建日志会明确写出「Indexed N pages」,N 不对就是范围错了。
双语的两套索引
两种语言各自建索引,查询时按当前语言加载对应的一套。这样中文查询不会命中英文页面,也不会出现「搜到了但内容对不上」的尴尬。
代价是构建时间翻倍——索引 600 页大约多花一秒,可以接受。
什么时候不该用
如果站点只有十几篇文章,搜索是负资产:多一次网络请求、多一个交互入口,读者还不如直接翻列表。我的判断标准是文章数超过两页再上搜索,之前一律不加。
现在索引 600 页、1.8 万词,构建多花一秒。这个代价换一个能用的搜索框,值。
评论
…