
llama.cpp 的第 11899 号构建:给多模态客户端一个「问它支持什么」的接口
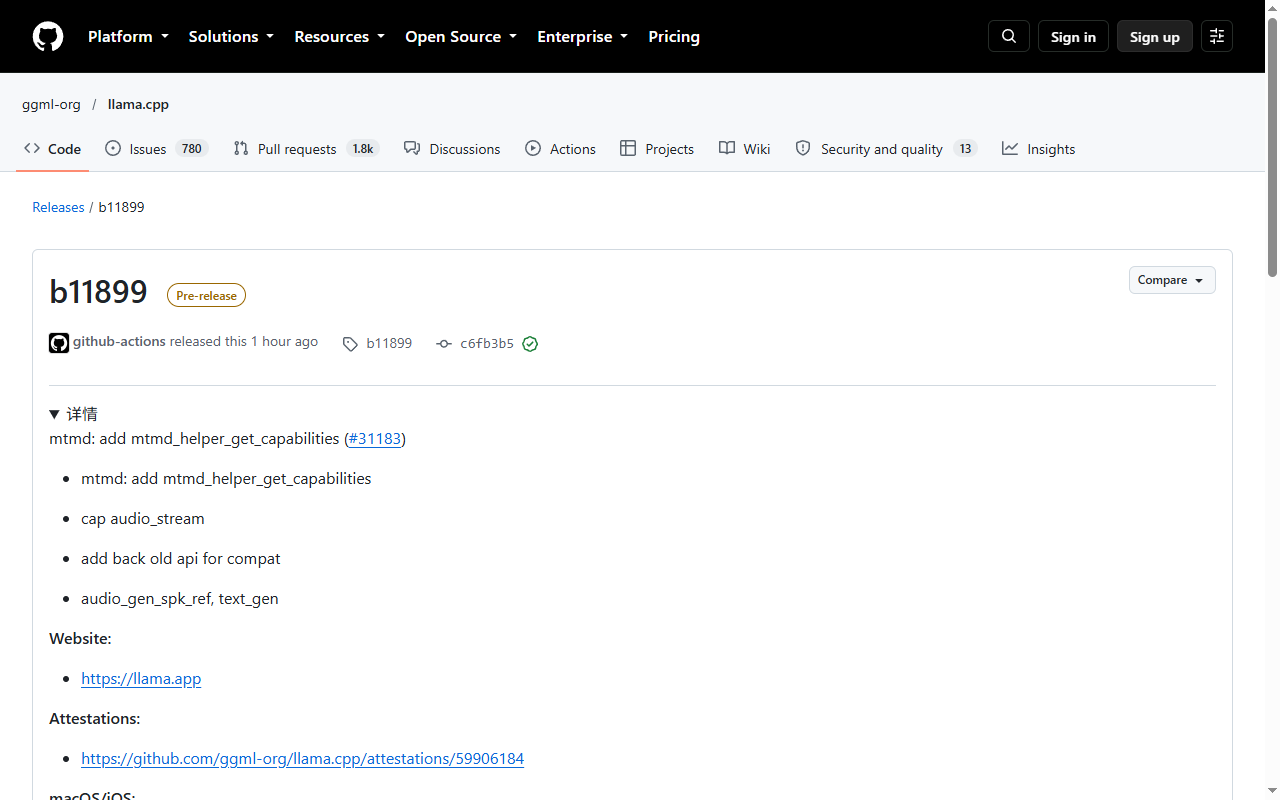
b11899 是每日构建,主要改动只有一条:mtmd 增加 get_capabilities,能报出音频流、参考音色、文本生成等能力,同时保留旧接口兼容。构建号本身说明这个项目的节奏。
llama.cpp 的 b11899 是 10 月 26 日的每日构建。这类构建通常只有一两条改动,这次的正文很短:
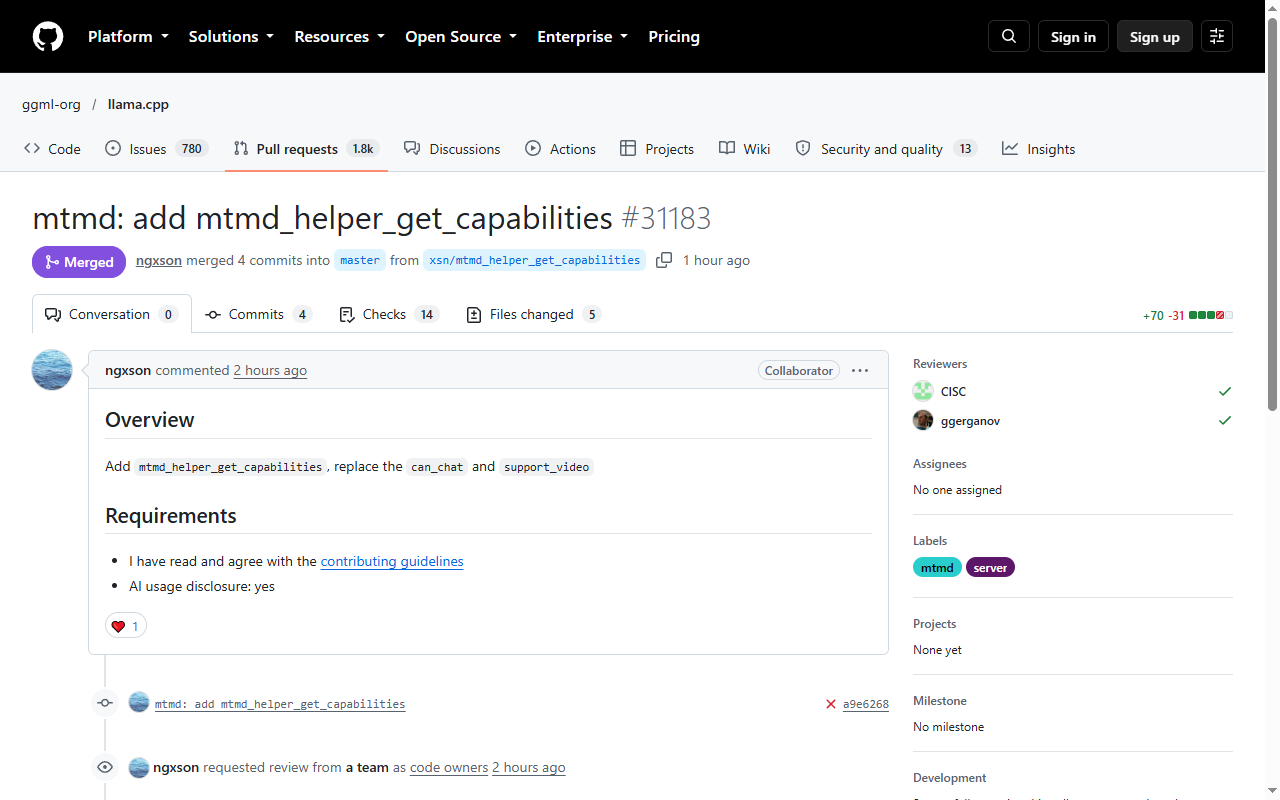
mtmd: add mtmd_helper_get_capabilities (#31183) —— 加
mtmd_helper_get_capabilities,覆盖audio_stream,保留旧 API 以兼容,新增audio_gen_spk_ref、text_gen。
先说构建号这件事
b11899 意味着这是第 11899 个构建。llama.cpp 用递增构建号发布,几乎每天都有新版,每个版本带十几到几十个平台的二进制。这不是「发版频繁」那么简单,它改变的是使用方式:
- 你不会盯着 changelog 找新特性,而是按需拉最新;
- 出问题时,第一句问的是「哪个构建号」;
- 上游修复的传播速度以小时计。
对一个推理库来说这是合理的:它的上游(模型格式、GPU 后端、量化算法)本身就在快速变化。
mtmd 是什么,能力探测解决什么问题
mtmd 是 llama.cpp 的多模态层(multimodal),负责把图片、音频与文本拼成模型能吃进去的序列。它的难点不在「拼」,在不同模型的输入形状完全不一样:
| 模型类型 | 输入 | 需要的能力 |
|---|---|---|
| 纯文本 | tokens | text_gen |
| 视觉 | 图像 patch | 图像编码器 + 投影层 |
| 语音输入 | 音频帧 | audio_stream |
| 语音输出 | 参考音色 + 文本 | audio_gen_spk_ref |
过去客户端只能靠「模型名 / 文件元信息」去猜:这个模型能不能吃音频?输出的是不是带音色的语音?猜错的后果不是报错,而是静默产出垃圾 —— 把音频当图片喂进去,模型照样给你吐一段文字。
mtmd_helper_get_capabilities 把这个猜测变成一次查询。发布说明里提到的三个能力标记就是全部:
audio_stream:能不能接收流式音频;audio_gen_spk_ref:能不能用参考音色生成语音(也就是「克隆音色」那类);text_gen:能不能做文本生成。
「保留旧 API」这句话值得单独看
PR 里明确写了 keep old API for compat。在一个每日构建的项目里,这不算小事 —— 上游可以随时破坏兼容,因为「用最新构建的人自己负责」。愿意保留旧接口,说明维护者把 mtmd 当成了有外部消费者的公共层,而不只是内部模块。
我判断一个 C/C++ 库是否值得依赖,看的就是这个:它有没有区分「内部实现」与「对外契约」。llama.cpp 的核心 API 一直在变(参数结构体改过好几轮),但 llama.h 层面的兼容性维持得不错;mtmd 现在也进入了这个阶段。
供应链:attestations
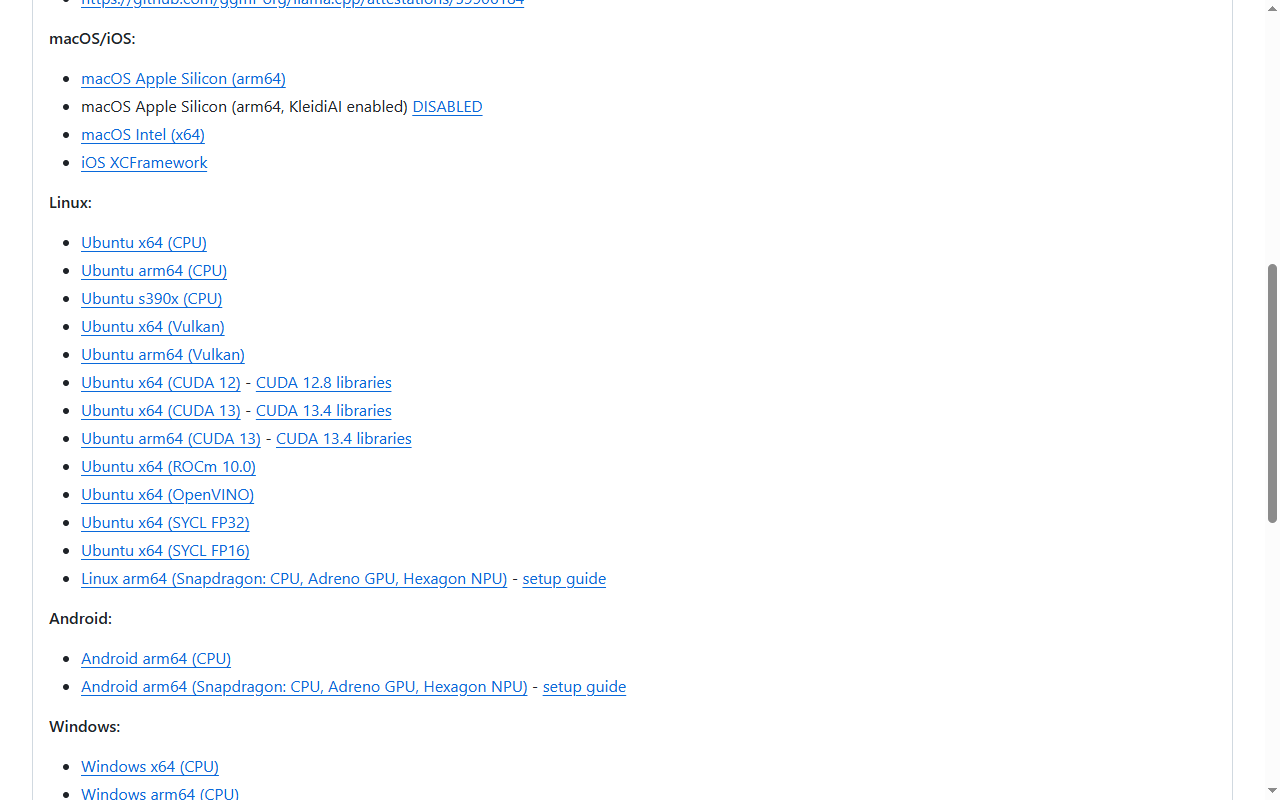
发布页里还有一条容易被忽略的信息:Attestations 链接。它指向 GitHub 的构建证明(provenance)—— 说明这些二进制是由哪个工作流、从哪个提交、在什么环境下构建出来的。
对一个需要下载二进制的推理库,这比签名更实用:签名只证明「这是官方发的」,证明(attestation)能证明「这是从这个提交、用这个工作流构建的」。想在生产里用预编译二进制,先看这一项。
我的用法建议
我不会追每日构建。我的策略是:
- 跟版本号,不跟构建号:看到「某个构建修了我踩的坑」再升,而不是每天拉。
- 能力探测优先于模型名:如果你的代码要处理多模态输入,先调一次
mtmd_helper_get_capabilities,别按文件名判断。 - 盯 attestations:下载二进制前确认构建来源,这条在多平台产物里尤其重要 —— 同一个构建号下有几十个文件,任何一个被替换都不容易发现。
llama.cpp 现在的位置有点像十年前的 ffmpeg:所有做本地推理的产品都会用到它,但没人愿意读它的源码。这种项目最值得关注的不是新特性,是它有没有把「对外契约」稳住 —— b11899 这条改动,恰好是在往这个方向走。
评论
…