
写古典密码工具时容易踩的三个坑
凯撒、维吉尼亚、Atbash 看起来都是「查表移位」,但大小写、非字母字符和密钥对齐这三处一旦处理错,结果会静默地不对。
站上的密码工具支持凯撒、ROT13、Atbash 和维吉尼亚四种。它们都是教科书级别的算法,写起来不到百行,但有三处细节处理错了不会报错,只会给出看起来像那么回事的错误结果。
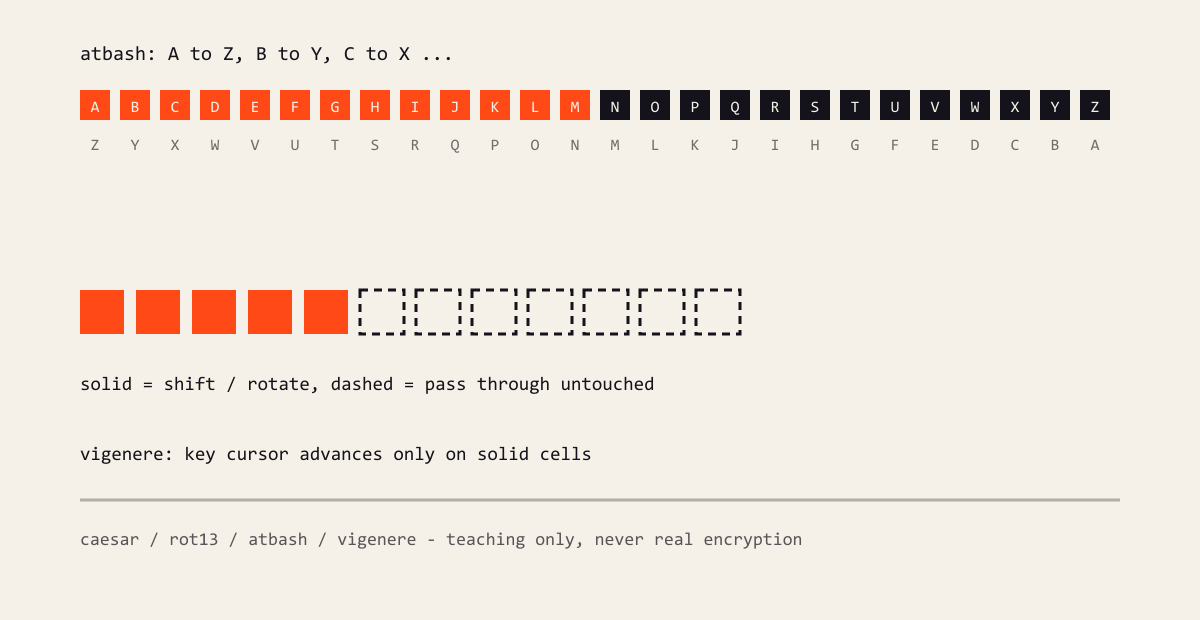
图:所有状态只在实心格里推进,虚线格(空格、数字、中文)原样透传。
凯撒:位移要归一化,非字母要原样保留
最直接的写法是对每个字符的编码加位移:
text.split('').map((ch) => String.fromCharCode(ch.charCodeAt(0) + shift))这段代码有两个问题。第一,位移为负或大于 26 时,会跑到标点区去;第二,空格和标点被一起移走了。
正确做法是先归一化,再只在字母区间内循环:
export function caesar(text: string, shift: number): string {
  const step = ((shift % 26) + 26) % 26;
  return text.replace(/[a-z]/gi, (ch) => {
    const base = ch >= 'a' ? 97 : 65;
    return String.fromCharCode(((ch.charCodeAt(0) - base + step) % 26) + base);
  });
}
replace 的正则只匹配字母,非字母自然原样保留。大小写各自维持——解密时也要能还原回原样。
维吉尼亚:密钥只跳过非字母,不是跳过位置
维吉尼亚的错误版本长这样:
for (let i = 0; i < text.length; i += 1) {
  shift = key.charCodeAt(i % key.length) - 65;
  out += shiftChar(text[i], shift);
}
问题在于 i 同时代表「原文位置」和「密钥位置」。原文里有空格时,密钥也会跟着往前跳一格,于是后面全部错位。
正确做法是维护一个只在字母上递增的密钥游标:
let cursor = 0;
for (const ch of text) {
  if (!/[a-z]/i.test(ch)) {
    out += ch;
    continue;
  }
  const shift = key.charCodeAt(cursor % key.length) - 65;
  out += shiftChar(ch, shift);
  cursor += 1;
}
这也是手算维吉尼亚时的规则:密钥只跟着字母走。
Atbash:它只对拉丁字母成立
Atbash 是「A 对 Z、B 对 Y」的镜像替换。看起来和凯撒一样是字符映射,但它的前提是字母表长度固定且对称。
如果实现成 String.fromCharCode(219 - code),遇到中文、数字或标点就会得到乱码。正确做法仍然是只匹配 [a-z]:
export function atbash(text: string): string {
  return text.replace(/[a-z]/gi, (ch) => {
    const base = ch >= 'a' ? 97 : 65;
    return String.fromCharCode(base + 25 - (ch.charCodeAt(0) - base));
  });
}
中文原样保留——这不是缺陷,而是这个密码的定义域本来就只有拉丁字母。
共同的教训
三个坑本质上是同一件事:这些算法定义在字母表上,而不是定义在字符串上。
所以实现时统一遵守两条:
- 用正则
[a-z]圈定作用域,圈外原样透传 - 所有状态(位移、密钥游标)只在圈内推进
工具页上还留了一行提示:古典密码只适合教学和谜题,不要用于任何真实加密。这句话比实现本身更重要。
评论
…