
Astro 7.4.2 把内容同步从 60 秒压到 1 秒内:只是换了一种数宽度的办法
4.4 万条内容的 chunked 存储,切块步骤从约 60 秒降到 1 秒以内,输出字节完全一致。这次改的不是算法,是「怎么知道一个字符占几个字节」。
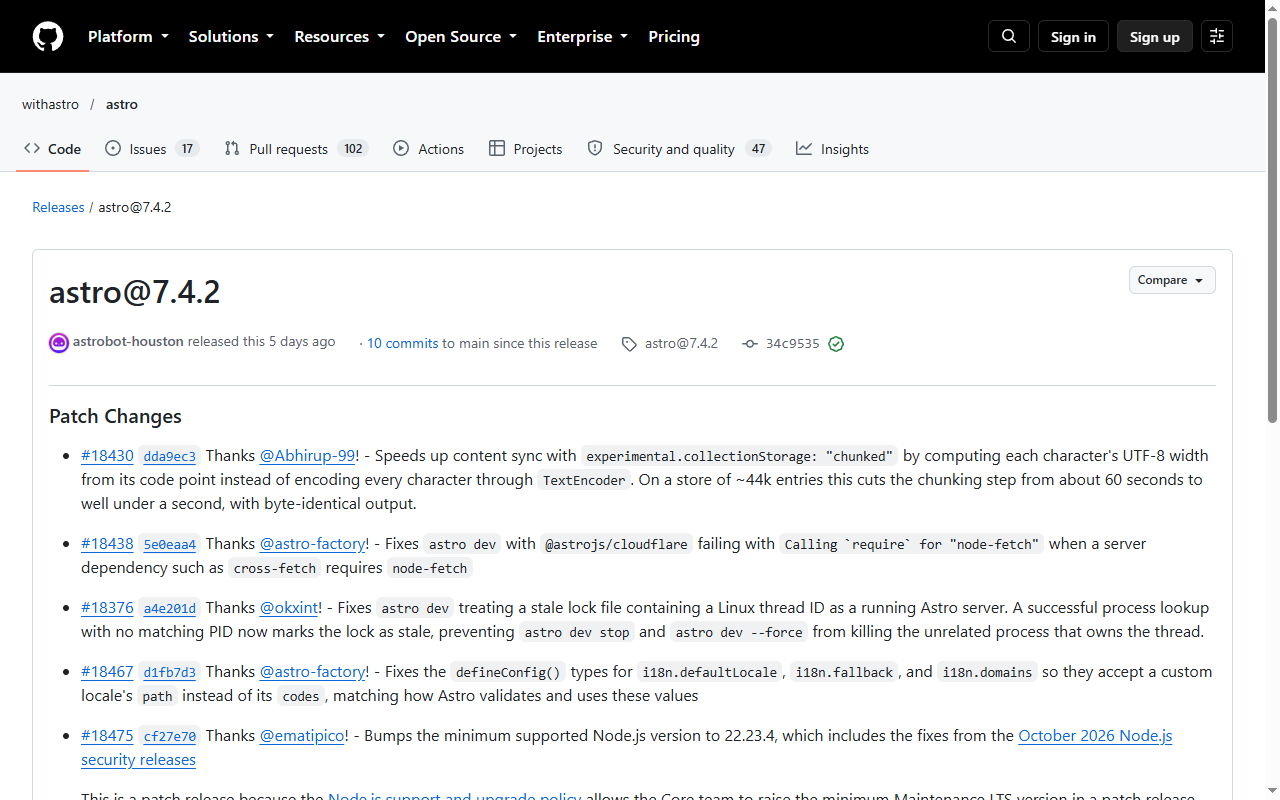
Astro 7.4.2 是 10 月 21 日的补丁版,里面有一条改动值得单独说:内容同步的切块步骤,从约 60 秒降到 1 秒以内,输出字节一致。4.4 万条内容的存储上测的。改的不是并发、不是缓存,是「怎么算一个字符占几个字节」。
慢在哪一步
Astro 的内容集合在 7.x 里可以走 experimental.collectionStorage: "chunked" —— 不再把整份 content store 塞进一个大文件,而是切成块。切块就得按字节预算算边界:一块最多多少字节,切到哪个字符为止。
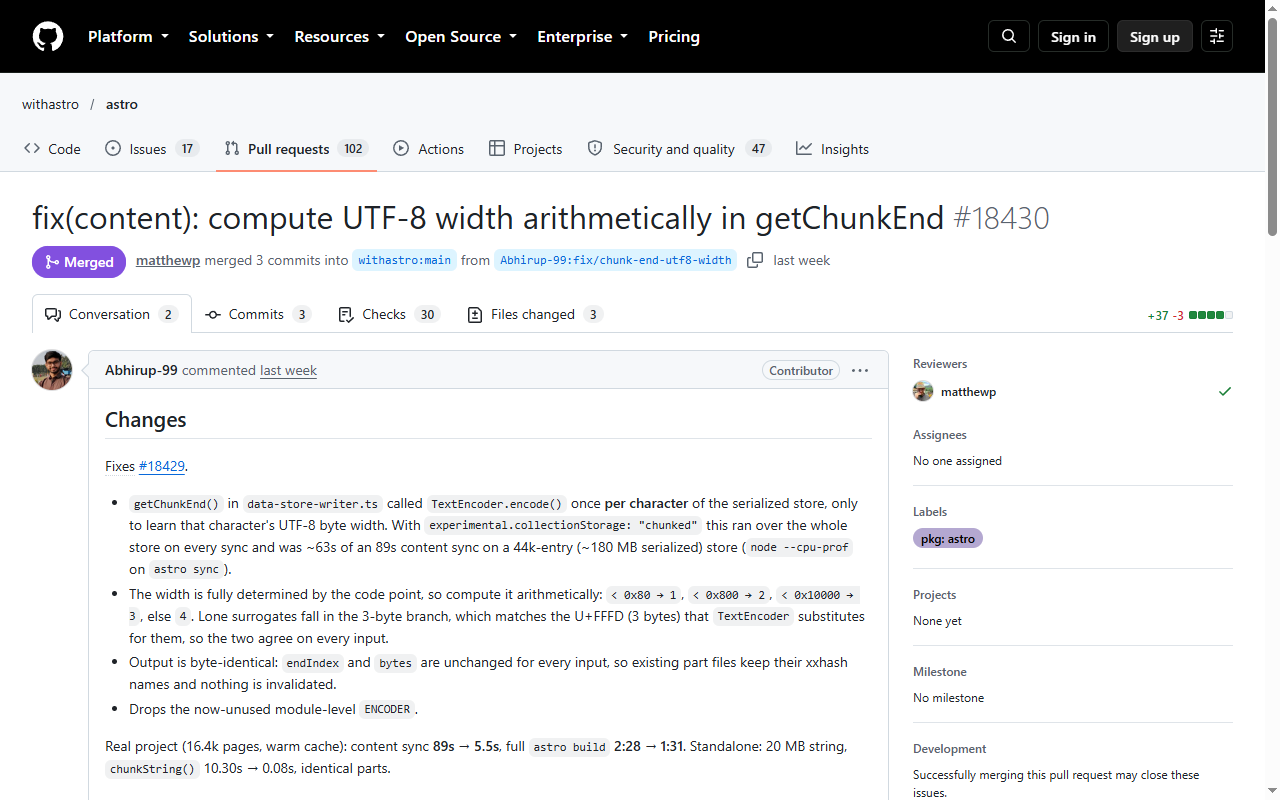
问题出在「每个字符占几个字节」这件事上。原来的实现是逐字符走一遍 TextEncoder:取出字符、编码成 Uint8Array、读长度、累加。逻辑没错,但每个字符都要分配一次编码器缓冲区。4.4 万条目乘以每条的字符数,这一步就变成了几十秒的纯 CPU 时间。
换成按码位查表
修复的做法是直接按 Unicode 码位算 UTF-8 宽度:码位落在哪个区间,就对应 1、2、3 还是 4 字节,是查表不是编码。
// 大意如此:按码位区间返回 UTF-8 字节数,不分配缓冲区
function utf8Width(cp: number): number {
  if (cp < 0x80) return 1;
  if (cp < 0x800) return 2;
  if (cp < 0x10000) return 3;
  return 4;
}
这不是新知识 —— UTF-8 的编码规则本来就把字节数写死在码位区间里。有意思的是为什么原来没这么做:TextEncoder 是浏览器与 Node 都有的标准 API,用它写出来最短、最不容易错,性能问题只有在数据量上来之后才暴露。而内容集合正好是那种「本地开发几百条、真实站点几万条」的东西,开发时永远测不出来。
为什么这条比「快了 60 倍」更值得记
两个细节让它比一般的性能补丁更可靠:
- 输出字节一致。发布说明明确写了 byte-identical —— 切块边界没变,只是算得快了。这类优化不需要回归测试去比对产物,因为产物本来就该一样;反过来说,如果改完产物变了,那就是改错了。
- 只影响开了 chunked 的实验特性。没有动默认路径,也就是说这次提速是「给已经踩坑的人递了把梯子」,不是全站行为变化。
我自己对这个特性的态度是:等它不再是 experimental 再开。内容集合的存储格式一旦出问题,坏的是构建,不是页面 —— 而构建挂了还能重跑,格式漂了就要重新生成整份 store。不过 60 秒降到 1 秒这个量级,说明「切块」这条路本身是对的,只是实现太朴素。
同一天还发了两条
astro dev配合@astrojs/cloudflare报Calling require for "node-fetch"的问题修了。触发条件很具体:某个服务端依赖(比如cross-fetch)在运行时去 requirenode-fetch。这类报错最难查,因为它只在 dev 出现,build 全程正常。@astrojs/vue@7.1.2与create-astro@5.3.1同步跟进,属于版本对齐。
我的判断
这次更新对本站没有直接影响 —— 我的内容集合才几百条,切块那一步本来就不慢。但它说明了一件事:Astro 现在的内容层是按「几万条」设计的,而不是按「个人博客几十篇」。这个方向对多语言站点很重要:两种语言、每篇带封面和正文图,条目数会比想象的多。
升级到 7.4.2 的成本是零,值得跟。真正要观察的是 chunked 什么时候转正 —— 转正那天,构建时间会从「分钟级」掉到「秒级」,那才是内容密集型静态站的分水岭。
评论
…