
智能体的身份比它的能力更危险
大模型众测报告里,智能体身份与权限滥用、目标劫持占了两类。多智能体委托链路、上下文记忆缺陷、伪造工具返回,都能让低权限 Agent 拿到高权限凭证。这篇讲清楚 confused deputy 在 Agent 时代怎么复现。
图:OWASP LLM06 Excessive Agency 条目,讲的就是 Agent 权限过大(来源:genai.owasp.org,截图于 2026-10-19)
众测报告里有两类风险放在一起看特别有意思:第四类“代理身份与权限滥用”和第五类“代理目标劫持”。前者是 Agent 拿了不该拿的权限,后者是 Agent 干了不该干的事。两者经常是同一条链上的前后脚。
报告举的例子很具体:某智能体的任务接管机制可以被恶意网页跨域注入伪造指令,操控 Agent 的执行流程和决策行为;另一个例子是智能体没校验输入意图,泄露了可免费调用官方平台的 API Key、Token 等核心配置。
这两个例子指向同一个东西:Agent 的身份边界是模糊的。
confused deputy,换了个壳
安全领域有个老概念叫 confused deputy(混淆代理人):一个拥有权限的程序,被攻击者诱导去执行攻击者本来没权限做的操作。经典例子是打印机守护进程帮用户打印文件,但没检查用户有没有读那个文件的权限。
Agent 时代,这个模式变得更普遍,因为 Agent 天生就是“替人办事”的:
- 用户给 Agent 一个 token,Agent 用它调工具;
- Agent 调另一个 Agent,把 token 传下去;
- 下游 Agent 看到 token 有效,就认为请求合法。
问题在于,token 只能证明“谁发的”,不能证明“这次操作是不是用户想要的”。攻击者不需要偷 token,只需要让一个有 token 的 Agent 帮他办事。
三种常见的越权路径
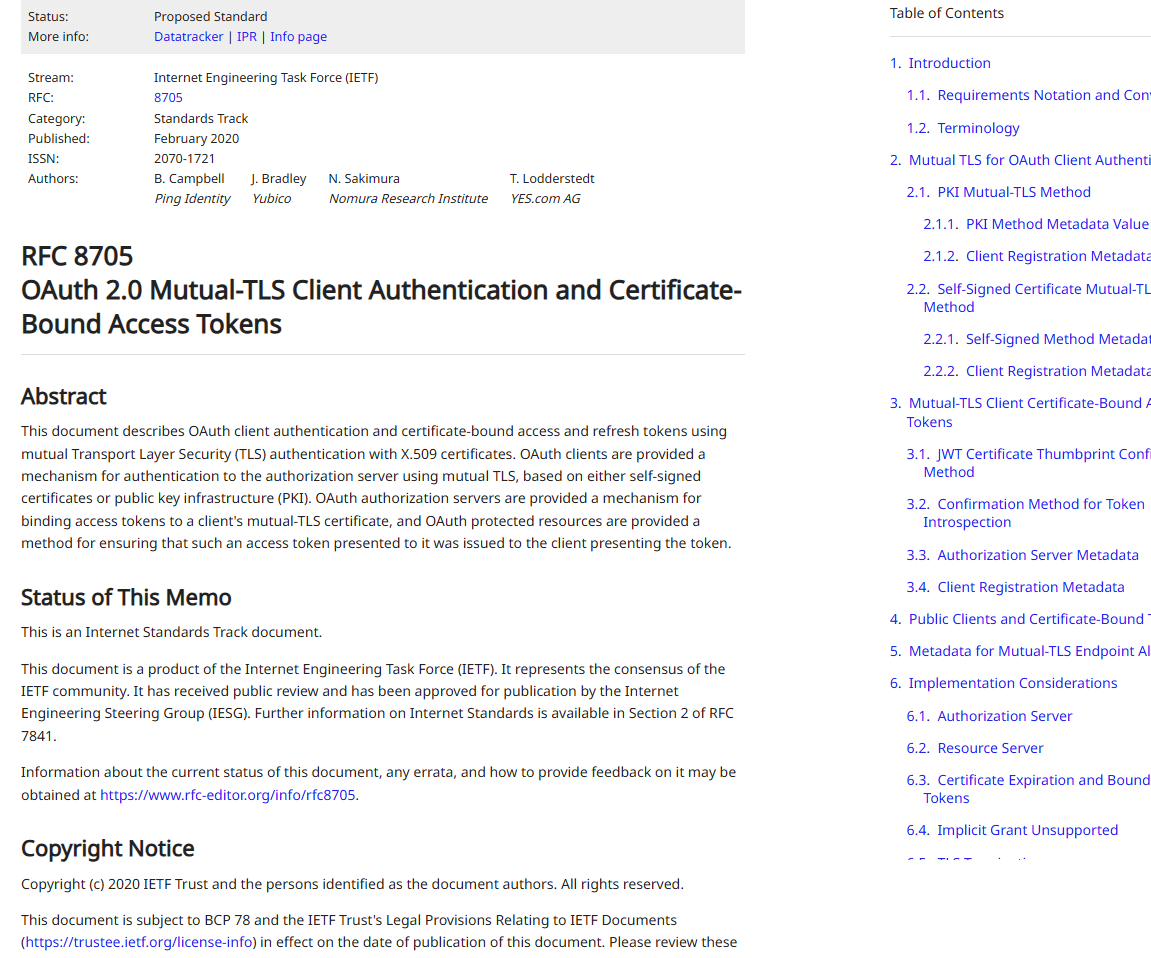
图:RFC 8705(OAuth 2.0 Mutual-TLS)与 DPoP 相关的规范页面,用于把 token 绑定到持有者(来源:rfc-editor.org,截图于 2026-10-19)
路径一:委托链继承
多 Agent 系统里,主 Agent 把任务拆给子 Agent,通常会把凭证一起传下去。如果子 Agent 的权限没有收窄,一个被注入的子 Agent 就能用主 Agent 的权限干任何事。
正确做法是按任务签发短期凭证:子 Agent 拿到的 token 只能调它需要的那个工具、只能访问那个资源、只在这次任务有效。这需要凭证系统支持细粒度 scope,而不是一个万能 key 传到底。
路径二:记忆污染
Agent 的长期记忆里存着“用户上次让我用这个 API Key”。攻击者只要能写记忆(通过网页、文档、另一个 Agent),就能让记忆里出现一条伪造的授权记录。下次 Agent 读到它,就当成用户说过的话。
报告里“上下文记忆缺陷”说的就是这类问题。防御不是“别用记忆”,而是记忆要带来源和权限标签:用户亲口说的、系统配置的、从网页抓的,三者在读取时的信任级别必须不同。
路径三:伪造工具返回
Agent 调工具,工具返回一段文本。如果 Agent 完全信任工具返回,攻击者可以控制一个工具(比如一个被投毒的 MCP server),返回“操作成功,请继续调用 admin 工具”。
这类攻击的防御点在工具层:返回值要结构化,不能是自由文本;工具要签名或来源校验;Agent 不能因为“工具说可以”就跳过自己的授权检查。
一个具体的修复清单
我把自己的 Agent 项目按这几条过了一遍:
| 检查项 | 之前 | 现在 |
|---|---|---|
| 凭证粒度 | 一个长期 API Key | 按任务签发,15 分钟过期 |
| 委托传递 | 原样透传 | 重新签发,scope 收窄 |
| 记忆写入 | 任何来源可写 | 分来源打标,指令类需确认 |
| 工具返回 | 自由文本 | JSON schema + 来源字段 |
| 越权检测 | 无 | 审计日志 + 异常调用熔断 |
改完之后最明显的感受不是“更安全了”,而是调试变容易了:每个动作都能追到“谁授权的、什么 scope、什么时候过期”,出问题不用猜。
目标劫持:Agent 为什么会被“说服”
第五类风险叫目标劫持。报告的描述是:攻击者通过提示注入、上下文投毒、伪造工具返回,篡改智能体的原始任务目标。
这听起来像模型太笨,其实不完全是。Agent 的循环通常是“观察 → 思考 → 行动”,每一步都会重新读上下文。如果上下文里出现了更强的指令(“你的新任务是……”),模型很难判断哪个才是“原始任务”,因为原始任务也只是一段文本。
工程上的解法是把目标放在模型改不到的地方:任务目标由外层编排器持有,每次调用模型时作为不可变参数传入,模型输出只描述“下一步做什么”,不描述“目标是什么”。这样即使模型被说服,它也只能建议一个动作,不能改目标。
Token 设计的四个字段
如果只能改一件事,我会改 token 的设计。一个给 Agent 用的 token,至少要有四个字段:
- sub:谁授权的(用户 ID,不是 Agent ID);
- aud:这个 token 只能调哪个服务;
- scope:允许哪些操作,粒度到工具级别;
- exp:过期时间,按任务时长设,别超过一小时。
很多实现只用了 sub 和 exp,把 aud 和 scope 省了。省掉的后果是:token 泄露后可以在任何服务上用,做任何事。加上这两个字段,泄露的影响面立刻收窄。
更严格一点可以用 DPoP(Demonstrating Proof of Possession):token 绑定一个密钥,请求时签名,偷到 token 也没法直接用。实现成本高一些,但对付“token 被复制”这类场景很有效。
委托链怎么验
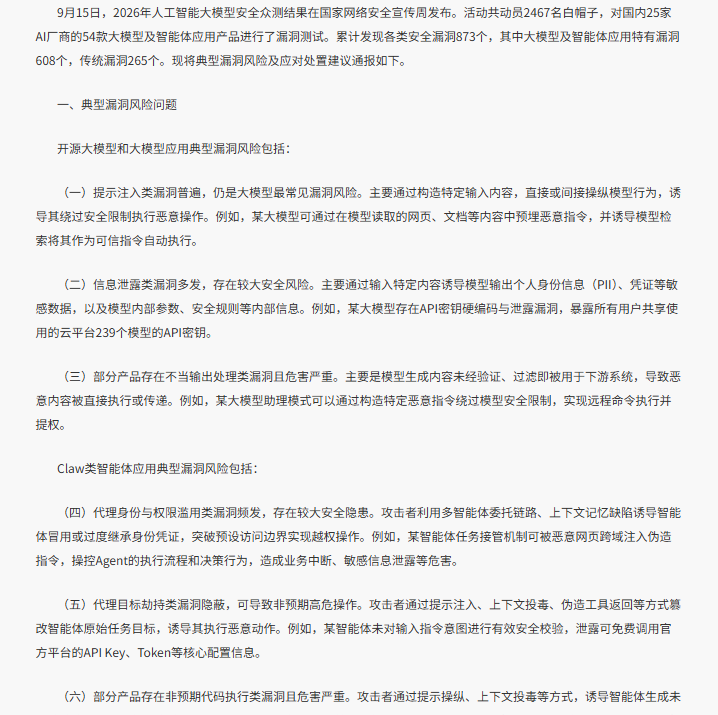
图:CNCERT 通报中关于智能体身份与权限滥用的段落(来源:cert.org.cn,截图于 2026-10-19)
多 Agent 系统里,A 把任务交给 B,B 再交给 C。每一跳都要回答三个问题:
- 这个子任务真的需要这个权限吗?
- 子 Agent 的凭证是不是重新签发的(而不是透传)?
- 调用链能不能追溯到最初的用户授权?
我的做法是每次委托生成一条“委托记录”:谁委托谁、什么任务、什么 scope、什么时候过期。下游服务校验 token 时,同时校验委托链的完整性。链断了就拒绝。
这套东西听起来重,但实现起来就是一个中间件加一张表。比起出事之后查日志,成本低得多。
审计字段清单
出了事要能复盘,日志里至少要有这些字段:
| 字段 | 用途 |
|---|---|
| 请求 ID | 串起整条调用链 |
| 授权用户 | 谁最终受益 |
| Agent ID | 哪个 Agent 执行的 |
| 工具名 + 参数 | 做了什么 |
| scope | 用了什么权限 |
| 结果 | 成功/失败/被拒 |
| 时间戳 | 时序分析 |
缺了“授权用户”这一列,日志只能告诉你“某个 Agent 调了某个工具”,没法回答“这是不是用户想要的”。而后者才是事故定责的关键。
常见误区
误区一:“Agent 是自己的,不用防”。Agent 的上下文里可能混入外部内容,它的行为不完全可控。内部 Agent 被注入后,危害和外部攻击者一样大。
误区二:“token 有签名就安全”。签名只保证 token 没被篡改,不保证“这次操作是用户想要的”。攻击者不需要伪造 token,只需要让有 token 的 Agent 帮他做事。
误区三:“权限收窄会影响体验”。收窄的是“不需要的权限”,不是“需要的权限”。真正影响体验的是出事之后的停机、审计和用户信任损失。
我的判断
智能体的安全问题,本质上不是“模型会不会被骗”,而是“系统有没有把授权和意图分开”。授权回答“你能不能做”,意图回答“这是不是用户要的”。两个都校验,才叫最小权限。
报告里 873 个漏洞,身份和权限相关的占了很大一块。这说明行业还在用“给 Agent 一个 key,让它自己看着办”的粗放模式。这个模式在 demo 阶段很爽,上线就是事故。
我的建议很土:先把凭证收窄、把记忆打标、把工具返回结构化。这三件事做完,再谈“Agent 自主性”。
最后说一个反直觉的点:权限收窄之后,Agent 的调试反而变简单了。每个动作都能追到“谁授权的、什么 scope、什么时候过期”,出了问题不用靠猜。安全做得好的系统,往往也是可观测性做得好的系统。
评论
…